
2026 年 Open WebUI VPS 推荐:自托管与服务器配置要求
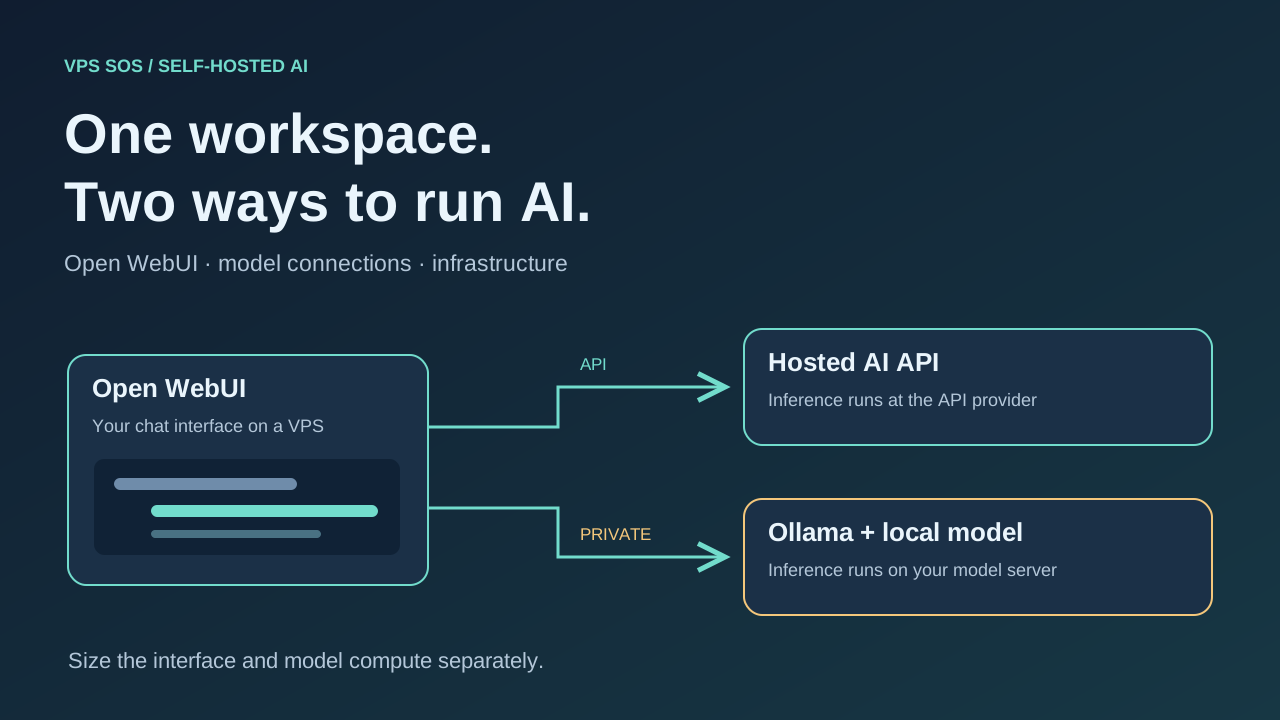
选择适合 Open WebUI 的 VPS,首先要确定 AI 模型在哪里运行。Open WebUI 是一个自托管 AI 聊天界面,提供浏览器工作区、对话记录、文档工具和模型服务连接。将它部署在 VPS 上,可以跨设备访问同一个工作区,也便于管理小团队的访问权限。
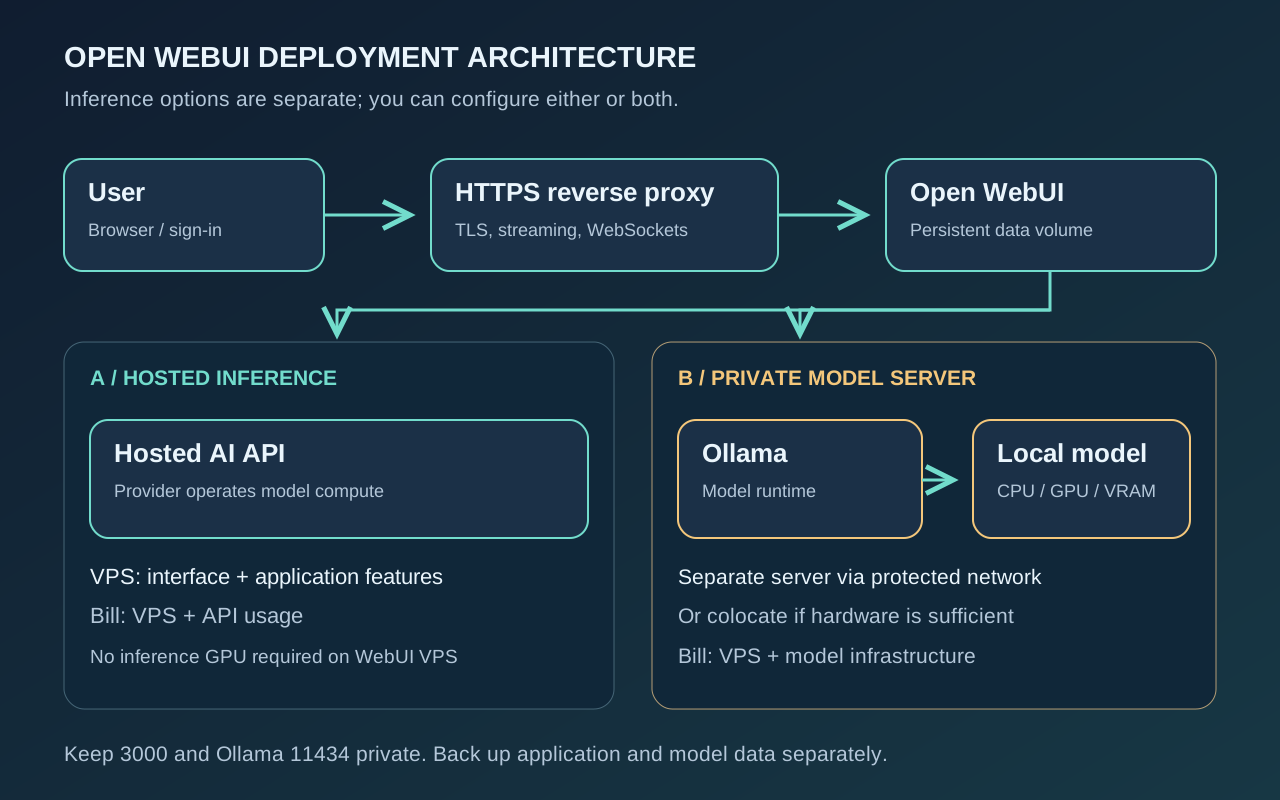
使用云端 AI API 时,VPS 运行界面,模型提供商负责推理。使用 Ollama 和下载到本地的模型时,你的模型服务器需要承担计算、内存以及可能的 GPU 资源需求。仅仅安装聊天界面,并不能让小型服务器获得大型模型推理能力。
本文对比 LightNode、Hetzner、DigitalOcean、Vultr、Akamai Cloud 和 Contabo,并介绍 Docker 部署方法。先决定由谁运行推理,再比较 CPU、内存、存储、流量、恢复方案和单独计算的模型费用。
核实日期:2026 年 10 月 26 日。 本文基于官方资料与编辑性容量规划,没有购买服务器进行性能测试。最新核实版本为 v0.12.4。价格取决于地区、税费、库存和订购条款。
Open WebUI VPS 推荐:快速对比
以下推荐配置用于运行界面及 API 连接。GPU 产品需要单独购买;无法确认的报价不填写具体价格。
| 服务商 | 推荐配置 | vCPU | 内存 | 存储 | GPU 产品情况 | 已核实月价 | 计费方式 | 适用场景 |
|---|---|---|---|---|---|---|---|---|
| LightNode | Agency Linux | 2 | 4 GB | 50 GB NVMe | 未核实普通 VPS 配备 GPU | 页面标示月度等值 $14.70 | 按小时;FAQ 说明设有上限 | 灵活测试 |
| Hetzner | CPX22,取决于库存 | 2 | 4 GB | 80 GB NVMe | 单独的 GEX45 GPU 独立服务器 | 查询当前价格;欧盟参考 €19.49,不含 IPv4 和增值税 | 按小时,设月度上限 | 欧洲开发项目 |
| DigitalOcean | Regular Basic 4 GiB | 2 | 4 GiB | 80 GiB SSD | 单独的 GPU Droplets | $24 | 按秒,设月度上限 | 首次云端部署 |
| Vultr | vc2-2c-4gb | 2 | 4 GB | 80 GB SSD | 单独的 Cloud GPU | 基础价 $20;圣保罗 $30 | 按小时,设月度上限 | 指定地区部署 |
| Akamai / Linode | Linode 4GB | 2 | 4 GB | 80 GB SSD | 单独的 GPU 实例 | 基础价 $24;部分地区不同 | 按小时,设月度上限 | 通用 Linux 托管 |
| Contabo | Cloud VPS Plus 4 | 4 个共享 vCPU | 8 GB | 150 GB NVMe | 单独的 GPU VPS | 查询当前价格 | 取决于合约或期限 | 内存和磁盘容量 |
资料来源:LightNode 套餐、Hetzner 套餐及价格调整、DigitalOcean、Vultr 套餐 API、Linode 实例类型 API、Contabo 配置及价格。
最低入门价应另作比较。 LightNode 的 $7.71 套餐为 1 vCPU/2 GB;DigitalOcean 从 $4/512 MiB 起;Nanode 为 $5/1 GB。这些配置都低于本文优先考虑的 2 vCPU/4 GB 起步档位。Hetzner 最低价产品的库存和 Contabo 的本地化结算价格仍需确认。更多预算取舍可参考便宜 VPS 选购指南。
Open WebUI 是什么?
Open WebUI 将自托管工作区与 Ollama、兼容 OpenAI 的 API 及其他受支持的模型连接方式结合起来,提供聊天记录、文件上传、检索增强生成(RAG)、用户管理和模型选择。部分功能需要额外的嵌入、内容提取或语音服务,详见官方功能指南。
Open WebUI 是交互界面,Ollama 是模型服务运行时。 托管 API 将推理交给另一家机构;下载本地模型则把资源需求转移到自己的模型服务器。同一个界面可以同时使用两者,但选择云端模型时,提示词及随附上下文会发送给该提供商。界面自托管,并不代表所有连接的服务都在本地处理数据。
Open WebUI 服务器配置要求
以下是用于初步评估的编辑性建议,不是官方最低配置或并发能力保证。
| 工作负载 | 建议评估的 CPU / 系统内存 | 存储 / GPU 规划 |
|---|---|---|
| 仅通过云端 API 聊天 | 2 vCPU / 2–4 GB;优先保留 4 GB 的余量 | 评估 30–50 GB SSD;不需要推理 GPU |
| API 加文档/RAG 任务 | 2–4 vCPU / 4–8 GB | 为上传文件和索引增长预留空间;本地嵌入任务增加计算需求 |
| WebUI 加小型本地模型 | 按具体模型、量化方式、上下文和并发量评估 | 模型文件及运行时内存;长期投入前先测试 |
| GPU 本地推理 | 配套 CPU、系统内存均取决于模型 | 显存应容纳权重、KV Cache 和运行时开销 |
CPU 与内存
使用云端 API 时,CPU 处理应用任务,而不是替提供商生成 Token。文档解析和并发上传可能造成内存峰值,还要给 Ubuntu、Docker、反向代理和监控预留资源。共享 vCPU 适合间歇性任务;持续本地推理需要进一步确认 CPU 代际、指令集支持、独享核心选项和使用条款。
存储与持久化数据
选择 SSD/NVMe,并为镜像拉取、日志、数据库增长、文档和备份保留可用空间。必须持久化挂载 /app/backend/data;Ollama 的模型目录也需要单独持久化。保留多个量化版本和容器镜像版本时,磁盘占用可能远高于界面本身。
GPU 要求
普通 VPS 套餐通常不含 GPU。使用托管推理时,WebUI 主机不需要推理 GPU。本地 NVIDIA 推理需要兼容的显卡、足够显存、主机驱动和容器支持。系统内存不能直接替代显存;将部分计算卸载到 CPU 会改变执行方式,需要实际评估。
云端 API 用户的配置需求
本地需要规划应用和可选 RAG 服务的资源,模型计算由 API 提供商收费。标准镜像包含本地功能所需依赖;slim 变体面向通过外部服务聊天的场景,多种文档、嵌入和语音流程需要额外的外部组件。应按功能选择,而不是只看镜像体积,详见镜像变体说明。
本地 LLM 推理的配置需求
需要考虑参数量、量化开销、上下文长度、KV Cache、并发请求、运行框架和模型架构。Ollama 上下文指南解释了更长上下文为何增加内存消耗。除模型权重外,还要为 WebUI 和操作系统预留内存。2、4 或 8 GB VPS 都不是适用于所有本地大模型的通用推荐。
2026 年适合 Open WebUI 的 6 家 VPS 服务商
这六家均提供支持管理权限及 SSH 访问的 Linux 基础设施,可以手动部署 Docker。下列普通 VPS 配置均不包含推理加速硬件。
1. LightNode:适合灵活按小时计费
LightNode 按小时 VPS适合连接 API 的个人聊天界面、开发环境和短期地区测试。可以评估 Agency 套餐:2 vCPU/4 GB/50 GB NVMe,页面标示月度等值 $14.70,包含 2 TB 流量。文档任务需要更多余量时,Premium 提供 4 vCPU/8 GB,月度等值 $27.70。
其优势包括 Linux、root 权限、多种配置,以及亚洲、中东、欧洲和美洲的多个地区。独立 IP 产品页列出静态独立 IP;仍需确认实际订单的 IP 和流量条款。Docker 和 WebUI 需要自行安装,本文不声称存在官方 Open WebUI 专用镜像。
计费 FAQ说明,服务器按小时计费,一个自然月内达到 672 小时后,服务器费用设有上限。实例关机后仍然计费。实际时价、超额流量和快照/备份费用应在控制台确认;本文未核实到公开备份价格,也未核实到合适的 LightNode GPU 产品,因此不将其作为本地大型模型推理推荐。
2. Hetzner:适合欧洲开发项目
CPX22 提供 2 vCPU/4 GB/80 GB NVMe,可用于连接 API 的应用界面。其德国/芬兰公开参考价为 €19.49,不含增值税和 IPv4;主 IPv4 另收 €0.50/月。库存限制意味着不能将它视为保证可购买的报价。欧盟套餐至少包含 20 TB 流量,新加坡额度不同。云服务器地区包括德国、芬兰、美国和新加坡。
优势是 Linux 工具和私有网络;局限是库存和地区价格差异,不能再默认每个现售套餐都最便宜。备份按服务器价格的 20% 收费,快照单独计量。本地推理需要另外选型:GEX45 独立服务器配备 RTX PRO 4000 Blackwell SFF,具有 24 GB 显存。它不是云 VPS,需查询当前价格和开通费。
3. DigitalOcean:适合首次部署云 VPS 的用户
Regular Basic 的 2 vCPU/4 GiB/80 GiB SSD 套餐为 $24/月,包含 4,000 GiB 流量。丰富的文档和常规 Droplet 工作流方便新手部署 API 界面,覆盖美洲、欧洲和亚太多个地区。普通 Droplet 的公网网络包含 IPv4;其他网络产品另有条款。
局限是计算资源之外还有费用:按比例计价的备份每周备份增加 20%,每日备份增加 30%;Droplet 快照为 $0.06/GB/月。普通 Droplet 仅有 CPU。单独计费的 RTX 4000 Ada GPU Droplet列出 20 GB 显存、8 vCPU、32 GiB 内存及 $0.76/GPU/小时。GPU 按秒计费,最低计费时长为五分钟,不适用普通月度上限;地区库存仍需确认。
4. Vultr:适合按地区选择 VPS
官方 API 列出的 vc2-2c-4gb 为 2 vCPU/4 GB/80 GB SSD,含 3,072 GB 流量,基础价 $20/月或 $0.027/小时。圣保罗覆盖价为 $30/月及 $0.041/小时。其列出的多个地区便于为 WebUI 和远程模型服务器选择合理的网络路径。
主要适用场景是云端 API 托管。优势是地区选择和常规 Linux 管理;局限是地区价格差异及共享 CPU 的性能波动。需确认 IPv4 和流量条款。自动备份增加实例费用的 20%;快照存储需另查报价。
Cloud GPU是单独产品。GPU 套餐 API列出 L40S/48 GB 显存、16 vCPU/180 GB 内存,价格为 $1.671/小时。核实时其地区列表为空,因此这只是产品目录参考,未验证实际可购买容量。选择本地推理前,应确认当前价格和地区库存。
5. Akamai Cloud:适合通用 VPS 托管
Linode 4GB 提供 2 vCPU/4 GB/80 GB SSD、4,000 GB 流量,价格为 $24/月或 $0.036/小时。API 列出的雅加达价格为 $28.80,圣保罗为 $33.60。备份基础附加费为 $5/月,部分地区不同。标准公网 IPv4 网络和 Linux 管理能力,适合 API 界面,或通过私有连接访问另一台模型主机的界面。
优势是常见的虚拟机模式和地区选择;局限是共享 CPU 和额外恢复费用。大多数地区的超额出站流量为 $0.005/GB,分布式地区条款不同。GPU 实例需单独购买:RTX 4000 Ada每张卡有 20 GB 显存。价格页列出 $0.52/小时和 $350 的月度参考价,但实时 GPU 类型 API 未返回月度上限,订购前应确认计费和库存。新 RTX PRO 6000 Blackwell/96 GB 产品需要申请访问,并非无限制开放购买。
6. Contabo:适合优先考虑内存容量的配置
Cloud VPS Plus 4 提供 4 个共享 AMD EPYC vCPU、8 GB 内存、150 GB NVMe 和 500 Mbit/s 端口,可作为 API 加文档工作负载的容量候选。配置文档列出 Performance VPS 包含五个快照,并可选购 Auto Backup。流量标示不限量,但受公平使用条款约束,不保证无限持续吞吐。
其局限在于共享计算资源,以及取决于结算选项的总价:查询当前价格,包括合约期限、开通费、地区、续费、税费和备份费用。确认包含的静态 IPv4 和所选地区;CPU 产品覆盖欧洲、美洲和亚洲。
单独的 GPU VPS配备 RTX PRO 6000 Blackwell Server Edition/96 GB 显存、18 vCPU/96 GB 内存/900 GB NVMe,地区为欧洲和美国中部。当前报价需要另查;该 GPU 产品不提供 Auto Backup。它是独立的本地推理选项,不是 Plus 4 的附带功能。
Open WebUI VPS 托管成本
比较总价前,先区分三种架构:
| 场景 | VPS / 基础设施 | 模型费用 | 其他成本 |
|---|---|---|---|
| A:WebUI + 托管 API | 例如 LightNode 月度等值 $14.70,或 DigitalOcean $24 | 提供商/模型的输入输出 Token 及功能费用 | 备份、域名、出站流量和管理 |
| B:WebUI + 远程 Ollama | 界面 VPS 加独立模型服务器 | 纯本地推理不收托管 Token 费 | 模型硬件租用或购置、存储、私有连接和备份 |
| C:WebUI + 本地 GPU | GPU 主机,可另设界面服务器 | 纯本地推理不收托管 Token 费 | 持久化磁盘、备份、出站流量和管理 |
例如,DigitalOcean 的 $24 套餐加每周按比例备份,为 $28.80,尚未包含 API 用量、域名、税费和其他费用。按 $0.76/小时计算,100 个 GPU 小时为 $76,假设使用 730 小时则为 $554.80。这些只是算术示例,不是 GPU 月度报价。保留 GPU Droplet 时,即使关机也不会停止计费。
API 成本取决于模型、输入输出 Token、缓存和工具,没有统一的每月 API 额度。自有本地硬件还需要承担电力、散热、折旧和维护成本;租赁硬件则将这些因素计入租金。还要考虑模型下载、文档保留、异地恢复所需存储及自己的运维时间。
如何在 Ubuntu VPS 上安装 Open WebUI
使用全新 Ubuntu 24.04 LTS amd64 或 arm64 VPS。Open WebUI 支持 Linux x86_64/ARM64;镜像和模型运行框架也应兼容。以下为依据官方快速入门调整的单实例 Docker 方案。
1. 连接服务器并安装 Docker Engine
使用提供商分配的地址和已授权密钥通过 SSH 登录:
ssh ubuntu@YOUR_SERVER_IP
free -h
df -h /
uname -m
遵循 Docker 的 Ubuntu 前置要求,已有服务器应先处理冲突软件包。在全新主机上添加官方软件源:
sudo apt update
sudo apt install -y ca-certificates curl openssl
sudo install -m 0755 -d /etc/apt/keyrings
sudo curl -fsSL https://download.docker.com/linux/ubuntu/gpg -o /etc/apt/keyrings/docker.asc
sudo chmod a+r /etc/apt/keyrings/docker.asc
sudo tee /etc/apt/sources.list.d/docker.sources > /dev/null <<EOF_DOCKER
Types: deb
URIs: https://download.docker.com/linux/ubuntu
Suites: $(. /etc/os-release && echo "$VERSION_CODENAME")
Components: stable
Architectures: $(dpkg --print-architecture)
Signed-By: /etc/apt/keyrings/docker.asc
EOF_DOCKER
sudo apt update
sudo apt install -y docker-ce docker-ce-cli containerd.io docker-buildx-plugin docker-compose-plugin
sudo docker run --rm hello-world
2. 保存固定密钥并启动应用
只创建一次以下受保护配置。重建容器时继续使用,绝不能将该文件或 API Key 提交到 Git。运行前替换示例域名:
sudo install -m 0700 -d /etc/open-webui
sudo sh -c 'umask 077; test ! -e /etc/open-webui/webui.env && {
  printf "WEBUI_SECRET_KEY=%s\n" "$(openssl rand -hex 32)"
  printf "WEBUI_URL=https://chat.example.com\n"
  printf "CORS_ALLOW_ORIGIN=https://chat.example.com\n"
} > /etc/open-webui/webui.env'
sudo docker volume create open-webui
sudo docker run -d \
  -p 127.0.0.1:3000:8080 \
  --env-file /etc/open-webui/webui.env \
  -v open-webui:/app/backend/data \
  --name open-webui --restart unless-stopped \
  ghcr.io/open-webui/open-webui:v0.12.4
sudo docker logs --tail 80 open-webui
curl -fsS http://127.0.0.1:3000/health固定版本的标准镜像支持本文讨论的功能。:main 跟随当前构建,:slim、:cuda 和 :ollama 分别满足不同需求。WebUI 使用 CUDA 镜像,并不意味着另一个 Ollama 容器会自动获得 GPU 访问权限。
3. 创建管理员账号并启用 HTTPS
开放公网访问之前,先从自己的电脑建立隧道:
ssh -L 3000:127.0.0.1:3000 ubuntu@YOUR_SERVER_IP访问 http://localhost:3000,注册首个管理员,然后在管理设置中关闭开放注册。将域名 DNS 指向 VPS。按照 Caddy 的官方软件包安装说明在主机安装 Caddy,配置 /etc/caddy/Caddyfile:
chat.example.com {
    reverse_proxy 127.0.0.1:3000 {
        flush_interval -1
    }
}
运行 sudo caddy validate --config /etc/caddy/Caddyfile 检查配置,再重新加载 Caddy。在提供商防火墙放行公网 TCP 80/443,并限制 SSH 访问。保持 3000 和 11434 为私有端口。Docker 发布的端口可能绕过 UFW 规则,因此本例将 WebUI 绑定在回环地址。流式响应和代理细节见 Open WebUI 的 Caddy 指南。
连接模型、发送测试聊天、上传无敏感信息的测试文档,再重启容器,确认历史记录和上传文件仍然存在。这些是需要在你的 VPS 上执行的验证步骤,不代表本文已经完成相关实测。
如何将 Open WebUI 连接到 AI 模型
连接托管 API
在 Settings → Admin → Connections 中添加受支持的提供商连接,填写其文档规定的基础 URL 和 API Key。使用提供商的兼容端点,地址通常包含 /v1;面向消费者的聊天订阅不一定包含 API 额度。确认模型访问权限及出站 HTTPS 连通性,参考各提供商的连接指南,然后选择模型测试。
连接同一台 VPS 上的 Ollama
使用独立 Docker 网络可以避免公开 Ollama 端口。只有评估完模型主机资源后才继续:
sudo docker network create ai-backend
sudo docker network connect ai-backend open-webui
sudo docker run -d --name ollama --restart unless-stopped \
  --network ai-backend -v ollama:/root/.ollama ollama/ollama
在管理连接设置中,将 Ollama URL 设为 http://ollama:11434。通过 sudo docker exec -it ollama ollama pull MODEL_TAG 下载所选模型;先阅读模型卡,再替换 MODEL_TAG。容器内的 localhost 指当前容器,不是另一项服务。重建 WebUI 时应重新保留该网络连接。Ollama Docker 指南介绍了 GPU 变体;NVIDIA 需要兼容驱动和 Container Toolkit,并在推理容器启动参数中加入 --gpus all。
连接独立服务器上的 Ollama
使用 WebUI 容器能够访问的私有 VPN/网络地址,或经过身份验证的 TLS 反向代理。将该地址填入 Ollama 连接配置;也可使用环境变量 OLLAMA_BASE_URL。已保存的管理设置可能覆盖环境变量默认值。不要将未经身份验证的 11434 端口公开到互联网。将模型服务器的入站访问限制为授权节点,并从实际容器网络测试。
VPS 可以运行本地 LLM 吗?
可以,前提是硬件适合所选模型及工作负载。仅 CPU 推理可以用于实验,但共享 vCPU 数量不能证明实际交互速度。量化可以降低权重存储和内存消耗,同时带来质量及运行框架方面的取舍。更长上下文和并发用户会增加 KV Cache 与执行内存需求,仅能放下权重还不够。
仅估算权重时,参数量 × 位数 ÷ 8 可得到原始字节数,尚未计入元数据、缓存和运行时内存分配,不能当作模型硬件要求。应检查具体模型卡、量化格式、运行框架支持及实际内存分配。使用 ollama ps 查看 CPU/GPU 分配,并在长期租用前测试代表性的上下文和并发请求。Ollama 与 Qwen 部署文章介绍了另一个模型服务工作流程。
Open WebUI 与其他自托管 AI 界面对比
| 界面 | 模型提供商支持 | 本地模型集成 | 文档 / RAG | 部署与资源 | 适用场景 |
|---|---|---|---|---|---|
| Open WebUI | 托管 API 和受支持协议 | Ollama 及兼容服务 | 上传、知识库和检索工具 | 起步可用一个应用容器;功能服务和推理增加资源需求 | 混合本地/云端聊天 |
| LibreChat | 多提供商和自定义端点 | 通过自定义端点连接 Ollama | 文件处理和可选 RAG 服务 | Docker 栈包含数据库和其他服务,需评估整个栈 | 可配置的提供商/Agent 流程 |
| AnythingLLM | 云端和本地提供商集成 | Ollama 及其他本地引擎 | 文档工作区、嵌入及向量配置 | 自托管 Docker;本地推理需要单独规划容量 | 以文档为中心的工作区 |
请根据所需功能核对 LibreChat 文档和 AnythingLLM 文档。上述区别是工作流程差异,不是性能排名;资源消耗取决于启用的组件。
安全与维护
启用 HTTPS,设置强管理员密码,限制注册并合理分配用户权限,同时为模型密钥设置消费上限。启用代码执行前应审查工具和插件。保留固定的 WEBUI_SECRET_KEY,将密钥和备份保护在 Git 仓库之外。按需明确配置官方环境变量,并在添加用户前阅读部署加固建议。
默认 SQLite/本地文件部署需要一致性备份时,先停止写入,再归档数据卷:
sudo install -m 0700 -d /var/backups/open-webui
sudo docker stop open-webui
sudo docker run --rm -v open-webui:/data:ro \
  -v /var/backups/open-webui:/backup alpine \
  sh -c 'tar czf /backup/openwebui-$(date +%Y%m%d-%H%M%S).tar.gz -C /data .'
sudo docker start open-webui检查归档完整性,保留加密异地副本,并安全备份环境变量文件。外部数据库、向量存储和对象存储需要各自的一致性备份。恢复到新的空数据卷,使用匹配的镜像和密钥,在私有环境中测试后再切换。
更新时先阅读发行说明、完成备份、拉取选定版本,再使用相同环境变量、端口、网络和数据卷重建容器。仅重启不会更新镜像。数据库迁移可能导致无法直接切回旧镜像,因此必须保留升级前备份。详见更新与恢复指南。
Open WebUI 常见问题排查
先执行以下只读检查,分享日志前应移除隐私内容:
sudo docker ps -a
sudo docker logs --tail 100 open-webui
sudo docker stats --no-stream
sudo docker inspect -f '{{.State.OOMKilled}}' open-webui
sudo docker inspect -f '{{json .Mounts}}' open-webui
free -h
df -h /
curl -fsS http://127.0.0.1:3000/health| 现象 | 排查方向 |
|---|---|
| 页面无法访问 | 检查容器状态、回环地址健康检查、DNS、反向代理和提供商防火墙 |
| 容器反复重启 | 从日志检查初始化、权限、密钥/配置或磁盘错误 |
| 无法连接 Ollama | 检查模型是否可用、连接 URL、Docker 网络/VPN、监听地址和访问规则 |
| API 身份验证失败 | 检查提供商 URL、有效密钥、账号余额和模型权限,不要打印密钥 |
| 内存不足 | 检查 OOM 状态和并发文档提取/模型任务,减少负载或增加容量 |
| 无法识别 GPU | 在模型主机运行 nvidia-smi;检查驱动、Toolkit、GPU 分配及 Ollama 实际使用情况 |
| 上传文件在重启后消失 | 确认重新挂载了相同持久化数据卷及外部存储配置 |
| 反向代理故障 | 检查 HTTPS 来源、WebSocket 升级、流式响应缓冲和响应超时 |
Open WebUI 应该选择哪家 VPS?
对于云端 API 聊天和按小时计费的实验,LightNode Agency 是实用的起步候选。重视云端操作文档的用户可以考虑 DigitalOcean,Akamai 则提供常规替代方案。连接远程 Ollama 时,应选择能够安全连接现有模型主机的界面部署地区。Vultr 值得按地区询价,Hetzner 则应确认欧洲地区的库存和价格。
对于本地 CPU 推理,应评估独享 CPU 和模型内存,而不是选择最便宜的界面主机。Contabo 偏重内存容量的配置值得测试,但不能据此承诺速度。对于 GPU 推理,应比较 DigitalOcean、Akamai、Contabo 或 Hetzner 实际可用的 GPU 产品;订购前确认显卡型号、显存、运行框架兼容性和完整费用。
如果同时部署多个服务,可参考 n8n 托管指南、Coolify 指南、Dokploy 指南和 Docker VPS 对比。它们的容器、构建和数据库都需要额外容量。
常见问题
哪种 VPS 最适合 Open WebUI?
按推理运行位置选择。LightNode 适合按小时计费的 API 托管,DigitalOcean 适合重视云端部署指南的用户。本地模型需要单独规划 CPU/GPU 主机。
Open WebUI 需要多少内存?
基本 API 聊天可从 2–4 GB 开始评估,优先保留 4 GB 的余量;文档任务可能需要 4–8 GB 或更多。这些是规划建议,不是官方最低配置保证。
Open WebUI 必须使用 GPU 吗?
通过托管 API 聊天不需要。本地嵌入、语音或模型推理是否需要、或能否受益于 GPU,取决于具体组件。
不安装 Ollama 可以运行 Open WebUI 吗?
可以,连接受支持的托管 API 或其他兼容模型服务器即可。
Open WebUI 可以使用云端 AI API 吗?
可以,在管理连接中配置兼容端点和密钥,并向提供商确认计费和数据处理条款。
可以在便宜 VPS 上托管 Open WebUI 吗?
可以,适用于内存、磁盘和恢复措施充足的小规模 API 工作负载。低入门价并不能证明其资源适合所需功能。
Open WebUI 托管费用是多少?
本文界面主机示例包括月度等值 $14.70 和 $24/月,尚未包含独立模型用量、备份、域名、税费及其他附加费用。
Open WebUI 可以运行本地 LLM 吗?
它连接 Ollama 等运行框架,由后者执行模型。硬件资源和模型可用性由运行框架所在主机决定。
Open WebUI 可以免费自托管吗?
软件可按其许可证与品牌标识条款免费自托管。基础设施、模型服务和可选商业安排另行计费。
如何备份 Open WebUI 数据?
对持久化数据卷进行一致性备份,安全保留密钥和配置,并单独备份外部存储。真正依赖备份前,应先测试恢复。
如果只想拥有共享界面,而不想维护推理硬件,可以先使用连接 API 的 VPS。如果已有 Ollama 服务器满足模型要求,就继续将其独立部署。只有在具体模型、上下文、并发和恢复预算确有需要时,才选择 GPU 服务器。