
Mejores VPS para Open WebUI en 2026: autoalojamiento y requisitos del servidor
El mejor VPS para Open WebUI depende de dónde se ejecuten tus modelos de IA. Open WebUI es una interfaz de chat con IA autoalojada que ofrece un espacio de trabajo en el navegador, conversaciones guardadas, herramientas para documentos y conexiones con proveedores de modelos. Alojarla en un VPS permite acceder desde varios dispositivos y gestionar el acceso de un equipo pequeño.
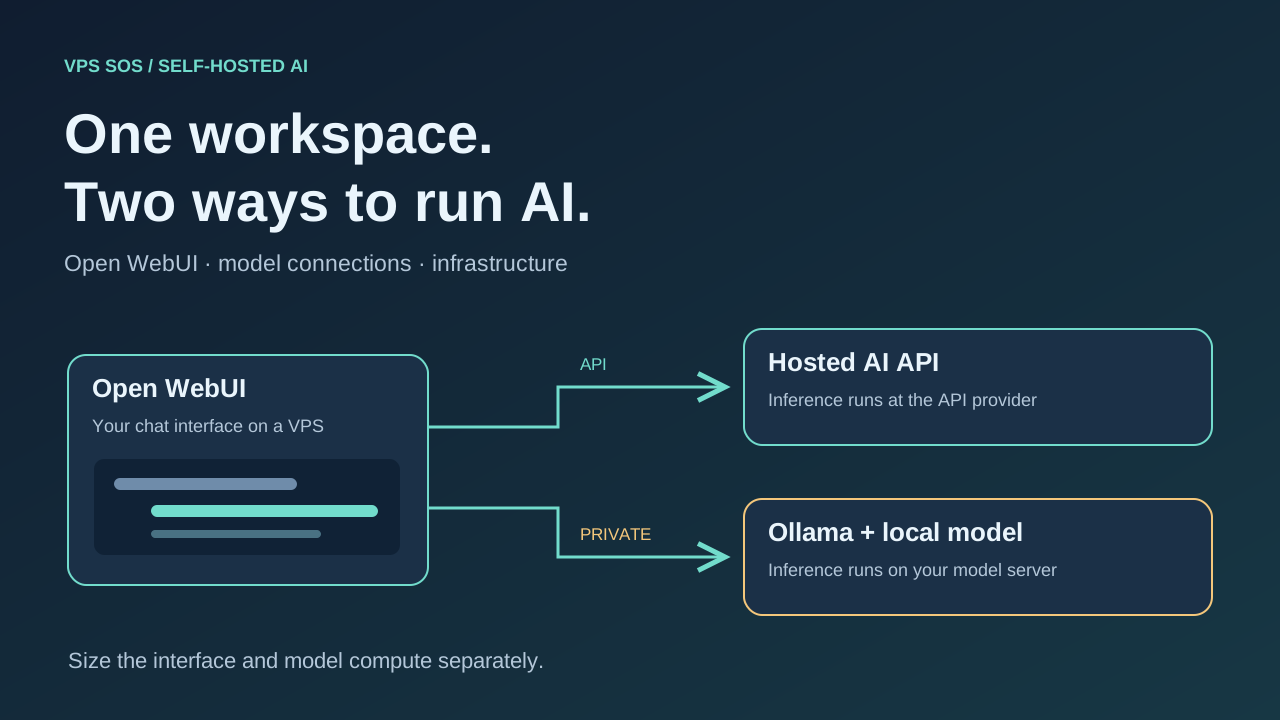
Con una API de IA en la nube, el VPS sirve la interfaz y el proveedor realiza la inferencia. Con Ollama y modelos descargados, tu servidor de modelos aporta el cómputo, la memoria y, cuando corresponda, la GPU. Instalar únicamente la interfaz no proporciona capacidad de inferencia de modelos grandes a un servidor pequeño.
Esta guía compara LightNode, Hetzner, DigitalOcean, Vultr, Akamai Cloud y Contabo, y explica el despliegue con Docker. Primero decide quién ejecutará la inferencia; después compara CPU, RAM, almacenamiento, transferencia, recuperación y la factura independiente del modelo.
Verificado el 26 de octubre de 2026. Fuentes oficiales y planificación editorial de capacidad; sin pruebas de servidores contratados. Última versión verificada: v0.12.4. Los precios dependen de la ubicación, los impuestos, la disponibilidad y las condiciones del pedido.
Mejores VPS para Open WebUI: comparación rápida
Estas configuraciones alojan la interfaz y las conexiones con API. Los productos con GPU se contratan por separado. Las cotizaciones no verificadas se dejan sin precio.
| Proveedor | Configuración recomendada | vCPU | RAM | Almacenamiento | Disponibilidad de GPU | Precio mensual verificado | Facturación | Ideal para |
|---|---|---|---|---|---|---|---|---|
| LightNode | Agency Linux | 2 | 4 GB | 50 GB NVMe | Sin GPU verificada en VPS convencional | Equivalente anunciado de $14.70 | Por hora, con límite según las FAQ | Pruebas flexibles |
| Hetzner | CPX22, sujeto a existencias | 2 | 4 GB | 80 GB NVMe | Servidor dedicado GEX45 independiente | Consultar precio actual; referencia UE €19.49 sin IPv4/IVA | Por hora, límite mensual | Proyectos europeos de desarrollo |
| DigitalOcean | Regular Basic 4 GiB | 2 | 4 GiB | 80 GiB SSD | GPU Droplets independientes | $24 | Por segundo, límite mensual | Primer despliegue en la nube |
| Vultr | vc2-2c-4gb | 2 | 4 GB | 80 GB SSD | Cloud GPU independiente | Base $20; São Paulo $30 | Por hora, límite mensual | Ubicación regional |
| Akamai / Linode | Linode 4GB | 2 | 4 GB | 80 GB SSD | Instancias GPU independientes | Base $24; variaciones regionales | Por hora, límite mensual | Hosting Linux general |
| Contabo | Cloud VPS Plus 4 | 4 compartidas | 8 GB | 150 GB NVMe | GPU VPS independiente | Consultar precio actual | Según contrato/plazo | Capacidad de memoria y disco |
Fuentes: planes de LightNode, planes de Hetzner y ajuste de precios, DigitalOcean, API de planes de Vultr, API de tipos de Linode, especificaciones de Contabo y precios.
El precio de entrada es otra comparación. LightNode anuncia $7.71 por 1 vCPU/2 GB; DigitalOcean empieza en $4/512 MiB; Nanode, en $5/1 GB. Son inferiores a la configuración inicial preferida de 2 vCPU/4 GB. Hay que confirmar las existencias de las ofertas más baratas de Hetzner y el precio localizado de Contabo. Nuestra guía de VPS baratos explica otras decisiones de presupuesto.
¿Qué es Open WebUI?
Open WebUI conecta un espacio de trabajo autoalojado con Ollama, API compatibles con OpenAI y otras conexiones de modelos admitidas. Incluye historial de chat, cargas de archivos, generación aumentada por recuperación (RAG), gestión de usuarios y selección de modelos. Algunas funciones necesitan servicios adicionales de embeddings, extracción o voz; consulta la guía oficial de funciones.
Open WebUI es la interfaz; Ollama es un entorno de ejecución que sirve modelos. Una API alojada traslada la inferencia a otra organización. Descargar un modelo local traslada sus necesidades al servidor de modelos. Una interfaz puede usar ambos, pero seleccionar un modelo en la nube envía el prompt y el contexto incluido a ese proveedor. Autoalojar la interfaz no convierte todos los servicios conectados en privados.
Requisitos del servidor de Open WebUI
Los siguientes son puntos de partida editoriales para evaluar capacidad, no mínimos oficiales ni garantías de concurrencia.
| Carga de trabajo | CPU / RAM del sistema que evaluar | Planificación de almacenamiento / GPU |
|---|---|---|
| Solo chat mediante API en la nube | 2 vCPU / 2–4 GB; preferiblemente 4 GB de margen | Evaluar 30–50 GB SSD; sin GPU de inferencia |
| API y documentos/RAG | 2–4 vCPU / 4–8 GB | Prever crecimiento de archivos e índices; los embeddings locales añaden cómputo |
| Modelos locales pequeños y WebUI | Dimensionar según modelo, cuantización, contexto y concurrencia concretos | Archivos del modelo y memoria de ejecución; probar antes de comprometerse |
| Inferencia local con GPU | RAM y CPU acordes con el modelo y la GPU | La VRAM debe alojar pesos, caché KV y sobrecarga del entorno de ejecución |
CPU y RAM
Con API en la nube, la CPU procesa tareas de la aplicación, no la generación de tokens del proveedor. El análisis de documentos y las cargas simultáneas pueden producir picos de memoria. Reserva recursos para Ubuntu, Docker, el proxy y la monitorización. Las vCPU compartidas sirven para tareas intermitentes; la inferencia local sostenida exige comprobar generación de CPU, instrucciones admitidas, opciones de núcleos dedicados y condiciones de uso.
Almacenamiento y datos persistentes
Utiliza SSD/NVMe y conserva espacio libre para descargar imágenes, registros, crecimiento de la base de datos, documentos y copias de seguridad. Monta /app/backend/data de forma persistente. El directorio de modelos de Ollama requiere persistencia aparte. Varias cuantizaciones y versiones de imágenes retenidas pueden ocupar mucho más disco que la propia interfaz.
Requisitos de GPU
Los VPS convencionales normalmente no incluyen GPU. La inferencia alojada no necesita una en el servidor de WebUI. La inferencia local con NVIDIA requiere una GPU compatible, suficiente VRAM, controladores en el host y compatibilidad con contenedores. La RAM del sistema no sustituye directamente a la VRAM; descargar parte del trabajo a la CPU cambia la ejecución y debe evaluarse.
Requisitos para usuarios de API en la nube
Presupuesta localmente la aplicación y los servicios RAG opcionales; el proveedor de API factura el cómputo del modelo. La imagen estándar incluye dependencias de funciones locales. La variante slim se orienta al chat mediante servicios externos y necesita componentes externos para varios procesos de documentos, embeddings y voz. Elige según las funciones, no solo el tamaño; consulta las variantes de imagen.
Requisitos de inferencia local de LLM
Considera parámetros, sobrecarga de cuantización, longitud de contexto, caché KV, solicitudes simultáneas, entorno de ejecución y arquitectura del modelo. La guía de contexto de Ollama explica por qué un contexto mayor consume más memoria. Reserva memoria para WebUI y el sistema operativo además de los pesos. Un VPS de 2, 4 u 8 GB no es una recomendación universal para LLM locales.
6 mejores proveedores de VPS para Open WebUI en 2026
Los seis ofrecen infraestructura Linux con acceso administrativo/SSH apta para instalar Docker manualmente. Ninguna de las configuraciones VPS convencionales siguientes incluye aceleración de inferencia.
1. LightNode: ideal para hosting VPS flexible por hora
El VPS por hora de LightNode encaja con chat personal mediante API, desarrollo y pruebas regionales breves. Evalúa Agency: 2 vCPU/4 GB/50 GB NVMe, equivalente mensual anunciado de $14.70 y 2 TB de transferencia. Premium ofrece 4 vCPU/8 GB por un equivalente de $27.70 si los documentos necesitan más margen.
Sus ventajas incluyen Linux, acceso root, varias configuraciones y ubicaciones en Asia, Oriente Medio, Europa y América. La página de IP dedicada anuncia una dirección estática dedicada; confirma las condiciones de IP y transferencia del pedido. Debes instalar Docker y WebUI; no se afirma que exista una imagen oficial específica de Open WebUI.
Las FAQ de facturación describen facturación por hora con un límite del coste del servidor al alcanzar 672 horas dentro de un mes natural. Las instancias detenidas siguen facturándose. Confirma tarifa horaria, exceso de tráfico y costes de snapshots/copias en la consola; no se verificó un precio público de copias de seguridad. Tampoco se verificó un producto GPU adecuado de LightNode, por lo que esta recomendación no incluye inferencia local de modelos grandes.
2. Hetzner: ideal para proyectos europeos de desarrollo
CPX22 aporta 2 vCPU/4 GB/80 GB NVMe para una interfaz conectada a API. La referencia publicada para Alemania/Finlandia es €19.49 sin IVA ni IPv4; la IPv4 principal añade €0.50/mes. Las restricciones de existencias impiden tratarla como una oferta disponible garantizada. Los planes europeos incluyen al menos 20 TB; Singapur tiene otras cuotas. Hay regiones cloud en Alemania, Finlandia, Estados Unidos y Singapur.
Destacan sus herramientas Linux y redes privadas. Las limitaciones son disponibilidad y diferencias económicas regionales: ya no conviene suponer que todos los planes actuales son los más baratos. Las copias cuestan el 20% del servidor; los snapshots se miden aparte. La inferencia local requiere otra selección: el servidor dedicado GEX45 incluye RTX PRO 4000 Blackwell SFF con 24 GB de VRAM. No es un VPS cloud; consulta precio y alta actuales.
3. DigitalOcean: ideal para iniciarse con un VPS en la nube
Regular Basic de 2 vCPU/4 GiB/80 GiB SSD cuesta $24/mes con 4,000 GiB de transferencia. Su documentación y flujo convencional de Droplets facilitan comenzar con una interfaz para API, en distintas regiones de América, Europa y Asia-Pacífico. La IPv4 pública forma parte de la red habitual del Droplet; otros productos de red tienen condiciones independientes.
La limitación son los servicios adicionales: las copias porcentuales añaden un 20% para frecuencia semanal o un 30% para diaria; los snapshots de Droplet cuestan $0.06/GB-mes. Los Droplets convencionales solo tienen CPU. El GPU Droplet RTX 4000 Ada, facturado aparte, anuncia 20 GB de VRAM, 8 vCPU, 32 GiB de RAM y $0.76/GPU-hora. Las GPU se facturan por segundo con un mínimo de cinco minutos y sin el límite mensual habitual; confirma existencias regionales.
4. Vultr: ideal para elegir ubicación regional
La API oficial enumera vc2-2c-4gb: 2 vCPU/4 GB/80 GB SSD, 3,072 GB de transferencia y precio base de $20/mes o $0.027/hora. São Paulo lo cambia a $30/$0.041. Sus numerosas regiones permiten elegir una ruta de red razonable entre WebUI y un servidor de modelos remoto.
Su uso principal aquí es el alojamiento con API en la nube. Ventajas: ubicaciones y administración Linux estándar. Limitaciones: precios regionales y variabilidad de CPU compartida. Confirma condiciones de IPv4 y tráfico. Las copias automáticas añaden un 20% del coste de instancia; consulta aparte el almacenamiento de snapshots.
Cloud GPU es otro producto. La API de planes GPU enumera L40S/48 GB de VRAM por $1.671/hora, con 16 vCPU/180 GB de RAM. La lista de ubicaciones estaba vacía al comprobarla: es una referencia de catálogo, no capacidad contratable verificada. Confirma precio y disponibilidad regional antes de elegir inferencia local.
5. Akamai Cloud: ideal para alojamiento VPS general
Linode 4GB aporta 2 vCPU/4 GB/80 GB SSD y 4,000 GB de transferencia por $24/mes o $0.036/hora. La API indica $28.80 para Yakarta y $33.60 para São Paulo. Las copias añaden $5/mes de base, con variaciones regionales. La IPv4 pública estándar y la administración Linux sirven para una interfaz con API o conectada de forma privada a otro host de modelos.
Ventajas: modelo de máquina virtual conocido y regiones disponibles. Limitaciones: CPU compartida y recuperación con coste adicional. El exceso de salida cuesta $0.005/GB en la mayoría de regiones; las distribuidas tienen otros términos. Las instancias GPU son independientes: RTX 4000 Ada tiene 20 GB de VRAM por tarjeta. La página anuncia $0.52/hora y una referencia mensual de $350, pero la API de tipos GPU no devuelve límite mensual; confirma facturación y existencias antes de contratar. La nueva RTX PRO 6000 Blackwell/96 GB requiere solicitar acceso y no es inventario abierto sin restricciones.
6. Contabo: ideal para priorizar la capacidad de RAM
Cloud VPS Plus 4 ofrece 4 vCPU AMD EPYC compartidas/8 GB/150 GB NVMe y puerto de 500 Mbit/s. Es una capacidad que evaluar para API y documentos. Las especificaciones incluyen cinco snapshots para Performance VPS y Auto Backup opcional. Se anuncia tráfico ilimitado sujeto a uso razonable, no caudal sostenido ilimitado garantizado.
Las limitaciones son el cómputo compartido y el total dependiente del pedido: consulta el precio actual, con plazo, alta, ubicación, renovación, impuestos y copias. Confirma IPv4 estática incluida y región; los productos CPU cubren Europa, América y Asia.
El GPU VPS independiente especifica RTX PRO 6000 Blackwell Server Edition/96 GB de VRAM, 18 vCPU/96 GB de RAM/900 GB NVMe en la UE y Estados Unidos central. Hay que comprobar la cotización; ese producto GPU no admite Auto Backup. Es una opción distinta para inferencia local, no una función de Plus 4.
Costes de alojamiento de Open WebUI en un VPS
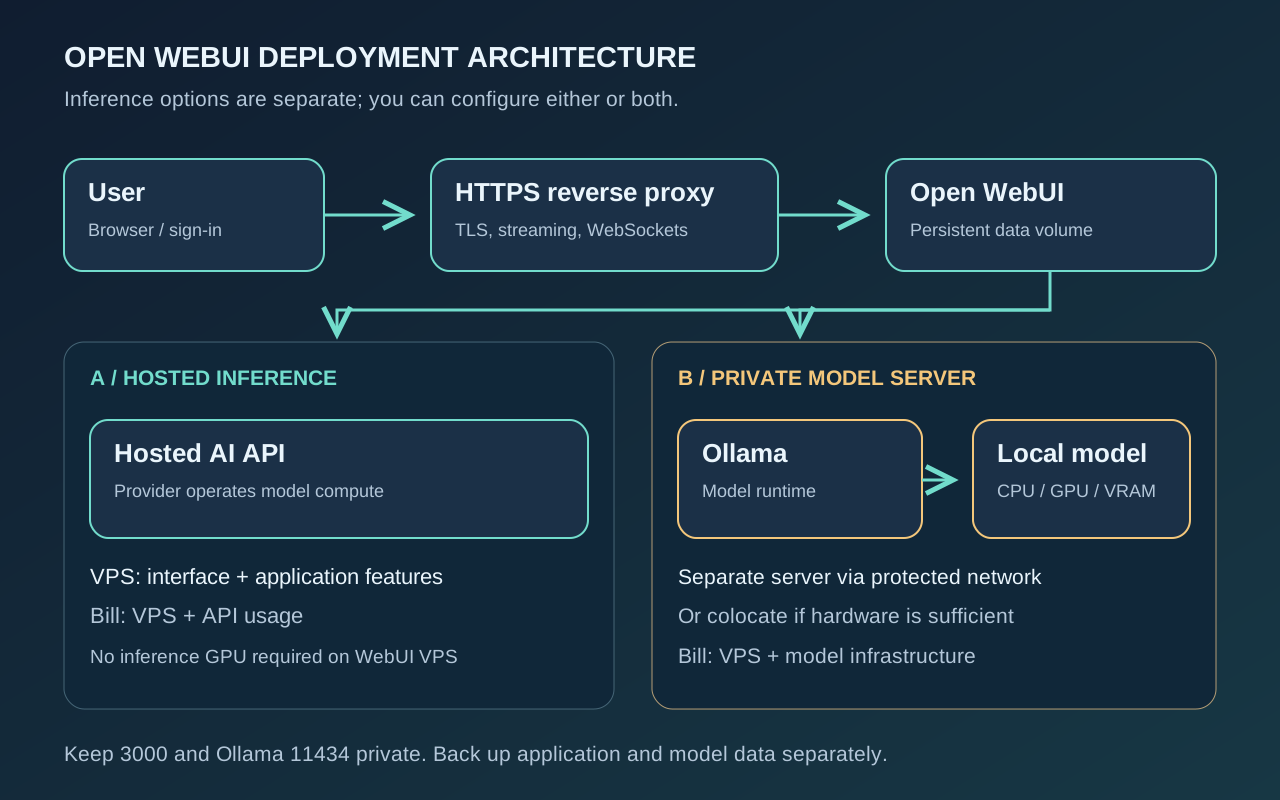
Distingue las tres arquitecturas antes de comparar totales:
| Escenario | VPS / infraestructura | Factura del modelo | Otros costes |
|---|---|---|---|
| A: WebUI + API alojada | Ejemplo: equivalente LightNode de $14.70 o DigitalOcean de $24 | Tokens de entrada/salida según proveedor y modelo, más funciones | Copias, dominio, salida de datos, administración |
| B: WebUI + Ollama remoto | VPS de interfaz y servidor de modelos independiente | Sin tarifa de tokens alojados para inferencia exclusivamente local | Alquiler o compra del hardware, almacenamiento, conectividad privada y copias |
| C: WebUI + GPU local | Host GPU y, opcionalmente, interfaz independiente | Sin tarifa de tokens alojados para inferencia exclusivamente local | Disco persistente, copias, salida de datos y administración |
Por ejemplo, DigitalOcean de $24 más copias porcentuales semanales suma $28.80 antes del uso de API, dominio, impuestos y extras. A $0.76/hora, 100 horas GPU cuestan $76, y unas hipotéticas 730 horas, $554.80. Son ejemplos aritméticos, no cotizaciones mensuales de GPU. Detener un GPU Droplet retenido no termina su facturación.
El coste de API depende del modelo, tokens de entrada/salida, caché y herramientas; no existe una cuota mensual universal. El hardware local propio también consume electricidad, refrigeración, depreciación y mantenimiento. El alquiler incorpora esos factores a su precio. Incluye almacenamiento para modelos, documentos y recuperación externa, además de tu tiempo de administración.
Cómo instalar Open WebUI en un VPS Ubuntu
Utiliza un VPS nuevo con Ubuntu 24.04 LTS amd64 o arm64. Open WebUI admite Linux x86_64/ARM64; elige imágenes y entornos de ejecución compatibles. Esta instalación Docker de una sola instancia adapta el inicio rápido oficial.
1. Conectar e instalar Docker Engine
Accede por SSH con la dirección del proveedor y una clave autorizada:
ssh ubuntu@YOUR_SERVER_IP
free -h
df -h /
uname -m
Sigue los requisitos de Docker para Ubuntu, resolviendo antes los paquetes incompatibles en servidores existentes. En un host limpio, añade el repositorio oficial:
sudo apt update
sudo apt install -y ca-certificates curl openssl
sudo install -m 0755 -d /etc/apt/keyrings
sudo curl -fsSL https://download.docker.com/linux/ubuntu/gpg -o /etc/apt/keyrings/docker.asc
sudo chmod a+r /etc/apt/keyrings/docker.asc
sudo tee /etc/apt/sources.list.d/docker.sources > /dev/null <<EOF_DOCKER
Types: deb
URIs: https://download.docker.com/linux/ubuntu
Suites: $(. /etc/os-release && echo "$VERSION_CODENAME")
Components: stable
Architectures: $(dpkg --print-architecture)
Signed-By: /etc/apt/keyrings/docker.asc
EOF_DOCKER
sudo apt update
sudo apt install -y docker-ce docker-ce-cli containerd.io docker-buildx-plugin docker-compose-plugin
sudo docker run --rm hello-world
2. Guardar un secreto estable e iniciar la aplicación
Crea esta configuración protegida una sola vez. Reutilízala al recrear contenedores; nunca la subas a Git ni publiques claves API. Sustituye el dominio de ejemplo antes de ejecutarla:
sudo install -m 0700 -d /etc/open-webui
sudo sh -c 'umask 077; test ! -e /etc/open-webui/webui.env && {
  printf "WEBUI_SECRET_KEY=%s\n" "$(openssl rand -hex 32)"
  printf "WEBUI_URL=https://chat.example.com\n"
  printf "CORS_ALLOW_ORIGIN=https://chat.example.com\n"
} > /etc/open-webui/webui.env'
sudo docker volume create open-webui
sudo docker run -d \
  -p 127.0.0.1:3000:8080 \
  --env-file /etc/open-webui/webui.env \
  -v open-webui:/app/backend/data \
  --name open-webui --restart unless-stopped \
  ghcr.io/open-webui/open-webui:v0.12.4
sudo docker logs --tail 80 open-webui
curl -fsS http://127.0.0.1:3000/health
La imagen estándar fijada admite las funciones descritas. :main sigue las compilaciones actuales; :slim, :cuda y :ollama cubren necesidades diferentes. Una imagen CUDA de WebUI no concede automáticamente acceso GPU a un contenedor Ollama separado.
3. Crear la cuenta administradora y activar HTTPS
Antes de dar acceso público, crea un túnel desde tu equipo:
ssh -L 3000:127.0.0.1:3000 ubuntu@YOUR_SERVER_IPAbre http://localhost:3000, registra al primer administrador y desactiva el registro abierto en los ajustes de administración. Apunta el DNS del dominio al VPS. Instala Caddy en el host mediante sus instrucciones oficiales de paquetes; configura /etc/caddy/Caddyfile:
chat.example.com {
    reverse_proxy 127.0.0.1:3000 {
        flush_interval -1
    }
}
Valida con sudo caddy validate --config /etc/caddy/Caddyfile y recarga Caddy. Permite TCP 80/443 público y restringe SSH en el firewall del proveedor. Mantén privados 3000 y 11434. Los puertos publicados con Docker pueden eludir UFW; por eso WebUI se vincula aquí a loopback. La guía de Caddy de Open WebUI detalla streaming y proxy.
Conecta un modelo, envía un chat de prueba, carga un documento inocuo, reinicia el contenedor y comprueba que historial y archivos persisten. Son verificaciones que debes realizar en tu VPS, no resultados que este artículo afirme haber obtenido.
Cómo conectar Open WebUI con un modelo de IA
Conectar una API alojada
En Settings → Admin → Connections, añade una conexión admitida con la URL base documentada y la clave API. Utiliza el endpoint compatible del proveedor, a menudo con /v1; una suscripción de chat para consumidores no incluye necesariamente crédito API. Comprueba acceso a modelos y HTTPS saliente. Sigue las guías específicas de proveedores y selecciona un modelo para probarlo.
Conectar Ollama en el mismo VPS
Una red Docker independiente evita publicar el puerto de Ollama. Continúa solo tras dimensionar el servidor de modelos:
sudo docker network create ai-backend
sudo docker network connect ai-backend open-webui
sudo docker run -d --name ollama --restart unless-stopped \
  --network ai-backend -v ollama:/root/.ollama ollama/ollama
Configura la URL de Ollama como http://ollama:11434 en las conexiones de administración. Descarga el modelo con sudo docker exec -it ollama ollama pull MODEL_TAG, sustituyendo MODEL_TAG después de consultar su ficha. Localhost dentro de un contenedor se refiere a ese contenedor, no al otro servicio. Conserva esta conexión de red al recrear WebUI. La guía Docker de Ollama cubre variantes GPU; NVIDIA necesita controladores compatibles y Container Toolkit, además de --gpus all en el contenedor de inferencia.
Conectar Ollama en un servidor independiente
Usa una dirección privada de VPN/red accesible desde el contenedor WebUI, o un proxy inverso TLS autenticado. Configura la conexión Ollama con esa dirección; también existe la variable OLLAMA_BASE_URL. Los ajustes de administración guardados pueden prevalecer sobre los valores iniciales del entorno. Nunca publiques el puerto 11434 sin autenticación. Limita la entrada al servidor de modelos a pares autorizados y prueba desde la red real del contenedor.
¿Se pueden ejecutar LLM locales en un VPS?
Sí, cuando el hardware encaja con el modelo y la carga seleccionados. La inferencia solo por CPU puede servir para experimentar, pero el número de vCPU compartidas no demuestra velocidad interactiva. La cuantización reduce almacenamiento de pesos y memoria, con compromisos de calidad y compatibilidad. Los contextos largos y usuarios simultáneos añaden caché KV y memoria de ejecución; no basta con que quepan los pesos.
Para una estimación solo de pesos, parámetros × bits ÷ 8 da los bytes brutos sin metadatos, caché ni asignaciones del entorno de ejecución. No es el requisito de hardware del modelo. Consulta ficha concreta, formato de cuantización, compatibilidad y asignación real. Usa ollama ps para comprobar reparto CPU/GPU y prueba contextos y solicitudes simultáneas representativas antes de un alquiler prolongado. Nuestro artículo sobre Ollama y Qwen explica otro flujo de servicio de modelos.
Open WebUI frente a otras interfaces de IA autoalojadas
| Interfaz | Proveedores de modelos | Integración local | Documentos / RAG | Despliegue y recursos | Ideal para |
|---|---|---|---|---|---|
| Open WebUI | API alojadas y protocolos admitidos | Ollama y servidores compatibles | Cargas, conocimiento y recuperación | Un contenedor inicial; servicios de funciones e inferencia necesitan más recursos | Chat local y cloud combinado |
| LibreChat | Varios proveedores y endpoints personalizados | Ollama mediante endpoints personalizados | Archivos y servicios RAG opcionales | Stack Docker con base de datos/servicios; dimensionar el conjunto | Flujos configurables de proveedores/agentes |
| AnythingLLM | Integraciones con proveedores cloud y locales | Ollama y otros motores locales | Espacios documentales, embeddings y configuración vectorial | Docker autoalojado; inferencia local con capacidad aparte | Espacios centrados en documentos |
Contrasta las funciones necesarias con la documentación de LibreChat y la documentación de AnythingLLM. Son diferencias de flujo, no clasificaciones de rendimiento; el consumo depende de los componentes activados.
Seguridad y mantenimiento
Usa HTTPS, credenciales administrativas robustas, registro restringido, permisos adecuados y límites de gasto para claves de modelos. Revisa herramientas/plugins antes de habilitar ejecución de código. Conserva WEBUI_SECRET_KEY estable y protege secretos y copias fuera de Git. Configura de forma deliberada las variables documentadas y revisa el endurecimiento del despliegue antes de añadir usuarios.
Para una copia consistente de SQLite y archivos locales predeterminados, detén las escrituras y archiva el volumen:
sudo install -m 0700 -d /var/backups/open-webui
sudo docker stop open-webui
sudo docker run --rm -v open-webui:/data:ro \
  -v /var/backups/open-webui:/backup alpine \
  sh -c 'tar czf /backup/openwebui-$(date +%Y%m%d-%H%M%S).tar.gz -C /data .'
sudo docker start open-webui
Comprueba la integridad del archivo, guarda una copia externa cifrada y protege el archivo de entorno. Las bases de datos, almacenes vectoriales y objetos externos necesitan sus propias copias consistentes. Restaura en un volumen vacío nuevo y prueba en privado con imagen/secreto compatibles antes de cambiar el servicio.
Para actualizar, revisa las notas, crea una copia, descarga la versión elegida y recrea el contenedor con el mismo entorno, puertos, red y volumen. Reiniciar no actualiza la imagen. Las migraciones de base de datos pueden impedir volver simplemente a la imagen anterior; conserva la copia previa. Sigue la guía de actualización y recuperación.
Problemas habituales de Open WebUI
Empieza con estas comprobaciones de solo lectura; elimina información privada antes de compartir registros:
sudo docker ps -a
sudo docker logs --tail 100 open-webui
sudo docker stats --no-stream
sudo docker inspect -f '{{.State.OOMKilled}}' open-webui
sudo docker inspect -f '{{json .Mounts}}' open-webui
free -h
df -h /
curl -fsS http://127.0.0.1:3000/health| Síntoma | Qué comprobar |
|---|---|
| Página inaccesible | Estado del contenedor, salud en loopback, DNS, proxy y firewall del proveedor |
| Reinicios continuos | Registros de inicialización, permisos, secreto/configuración o errores de disco |
| Sin conexión a Ollama | Disponibilidad del modelo, URL, red Docker/VPN, dirección de escucha y reglas de acceso |
| Error de autenticación API | URL, clave activa, saldo de cuenta y permisos del modelo sin mostrar la clave |
| Memoria agotada | Estado OOM y extracciones/modelos concurrentes; reducir carga o ampliar capacidad |
| GPU no detectada | Ejecutar nvidia-smi en el host del modelo; comprobar controladores, Toolkit, asignación GPU y uso de Ollama |
| Archivos perdidos tras reiniciar | Mismo volumen persistente y configuración de almacenamiento externo conectados de nuevo |
| Fallos de proxy inverso | Origen HTTPS, actualización WebSocket, buffering del streaming y tiempos de espera |
¿Qué VPS elegir para Open WebUI?
Para chat con API en la nube y pruebas por hora, LightNode Agency es un candidato inicial práctico. DigitalOcean encaja si valoras procesos cloud documentados; Akamai ofrece otra opción convencional. Para Ollama remoto, elige una región de interfaz con una ruta protegida al servidor existente. Solicita una cotización regional a Vultr y comprueba existencias/precios europeos de Hetzner.
Para inferencia CPU local, evalúa CPU dedicada y memoria del modelo en lugar del host de interfaz más barato. Las configuraciones de RAM de Contabo merecen pruebas, no promesas de velocidad. Para inferencia GPU, compara productos realmente disponibles de DigitalOcean, Akamai, Contabo o Hetzner; confirma modelo de GPU, VRAM, compatibilidad y coste total antes de pedirlos.
Si despliegas varios servicios, nuestras guías de hosting n8n, Coolify, Dokploy y VPS Docker explican cargas relacionadas. Sus contenedores, compilaciones y bases de datos necesitan capacidad adicional.
Preguntas frecuentes
¿Cuál es el mejor VPS para Open WebUI?
Elige según dónde ocurra la inferencia. LightNode encaja con API y facturación horaria; DigitalOcean, con una instalación cloud guiada. Los modelos locales necesitan dimensionar su propio host CPU/GPU.
¿Cuánta RAM necesita Open WebUI?
Evalúa 2–4 GB para chat básico con API, preferiblemente 4 GB de margen; los documentos pueden necesitar 4–8 GB o más. Son sugerencias de planificación, no mínimos oficiales garantizados.
¿Open WebUI necesita una GPU?
No para chat con API alojada. Embeddings, voz o inferencia locales pueden beneficiarse de aceleración o necesitarla según sus componentes.
¿Puedo usar Open WebUI sin Ollama?
Sí. Conecta una API alojada admitida u otro servidor de modelos compatible.
¿Puedo utilizar Open WebUI con API de IA en la nube?
Sí. Configura endpoint y clave compatibles en administración y verifica facturación y tratamiento de datos del proveedor.
¿Puedo alojar Open WebUI en un VPS barato?
Sí, para una carga modesta con API y suficiente memoria, disco y recuperación. Un precio inicial bajo no demuestra que cubra tus funciones.
¿Cuánto cuesta alojar Open WebUI?
Los ejemplos de interfaz comparados incluyen un equivalente de $14.70 y $24/mes, antes de modelos, copias, dominios, impuestos y extras.
¿Open WebUI ejecuta LLM locales?
Se conecta a un entorno como Ollama que los ejecuta. El hardware y la disponibilidad del modelo corresponden al host de ese entorno.
¿Open WebUI es gratuito para autoalojamiento?
El software permite autoalojamiento gratuito sujeto a sus condiciones de licencia y marca. Infraestructura, servicios de modelos y acuerdos comerciales opcionales se pagan aparte.
¿Cómo hago una copia de los datos de Open WebUI?
Copia el volumen persistente de forma consistente, conserva secreto/configuración de forma segura y cubre almacenes externos por separado. Prueba la restauración antes de confiar en la copia.
Empieza con un VPS conectado a API si quieres una interfaz compartida sin administrar hardware de inferencia. Mantén separado un servidor Ollama existente si ya cubre el modelo. Elige un servidor GPU solo cuando el modelo, contexto, concurrencia y presupuesto de recuperación concretos lo justifiquen.